想分离人声和背景音乐,先要知道它和平常说的「提取音频」不是一回事。提取音频是把视频里的整条声音原样取出来,人声、伴奏、杂音全在里面;分离人声和背景音乐是把这条混好的声音再拆开,拆成干净的人声一条、伴奏一条。前者几乎所有剪辑软件和转换工具都能做,后者要靠专门的分离模型。很多人搜了半天工具,拿到手的其实是整轨,就是没分清这两步。所以下面先把音频提取和人声分离区别讲清楚,再按类别比工具。
(官方说明)提词匠有 iPhone、安卓 App 和微信小程序三个入口,同一个微信账号登录,积分和会员三端互通。
按什么来比:五个要看的地方
我前后试过十来种做法,最后觉得挑工具主要看五点:
- 输出是什么:整轨一条,还是人声、伴奏分开两条,甚至鼓、贝斯、其他乐器四条。
- 拆得干不干净:人声里有没有残留的伴奏,伴奏里有没有「鬼声」,也就是隐约还能听到的歌声。
- 在哪里跑:手机、电脑本地,还是上传到网站的服务器上处理。
- 上手难度:点几下就行,还是要装 Python、下模型、敲命令。
- 素材从哪来:大多数分离工具只收音频文件,手里是视频的话,要先多一步把音频抽出来。
按这五点,工具大致能分成三类:只做整轨提取的、能做人声分离的电脑软件和开源模型、在线人声分离网站。下面一类一类说。
第一类:只做整轨提取,不拆人声
这一类工具做的是音频提取,不是人声分离。它们的价值在于把视频变成音频,给后面的分离步骤准备素材,或者你本来就只需要整段声音。
提词匠:手机上把视频抽成 MP3
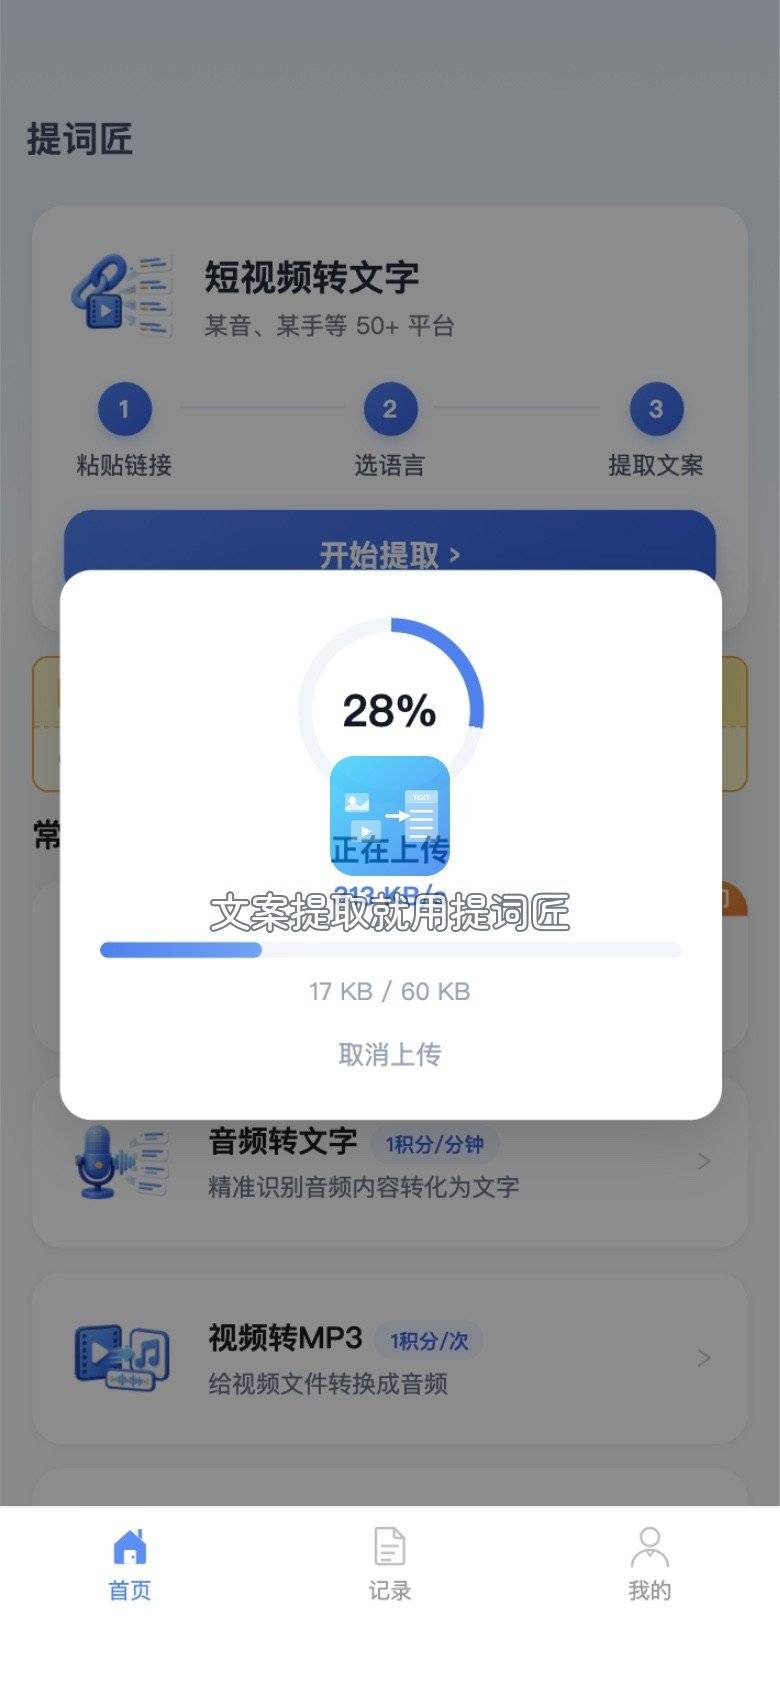
我手机上用提词匠的「视频转MP3」做这一步。iPhone、安卓都有 App,不想装的话微信里搜小程序也能用,几个入口登的是同一个微信号,积分是一份。首页点视频转MP3,选视频上传,云端转完给一个 MP3,按次计费,1 积分一次。
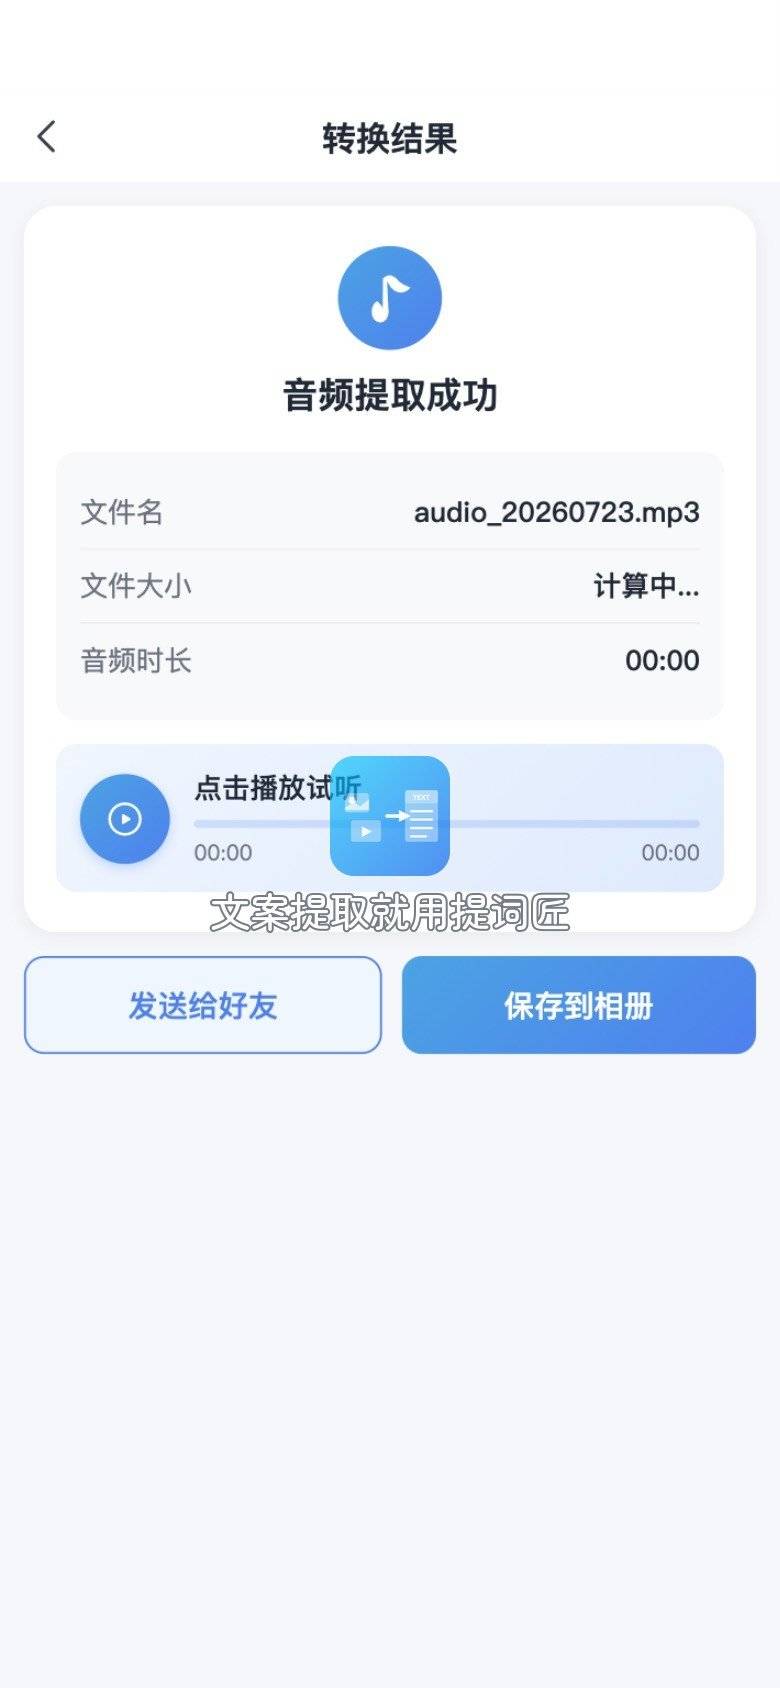
结果页可以先试听,再保存。小程序里「发送给好友」发的是真正的 MP3 文件,「保存到相册」只能存成黑色画面的视频;App 里点「保存到手机」,存下来就是 MP3。
要说清楚的是:提词匠只做整轨抽 MP3,没有分离人声和背景音乐的功能。它适合放在流程的第一步,手机里的视频先变成音频文件,再交给后面的分离工具。另外它要联网上传,一次只处理一个文件。
剪映专业版:时间线上的「分离音频」
剪映专业版里,视频拖到时间线后右键,有一个分离音频。名字容易让人误会,它做的是把视频里的整条声音拆到单独的音频轨上,方便你单独剪、调音量、导出,不是把人声和伴奏拆开。
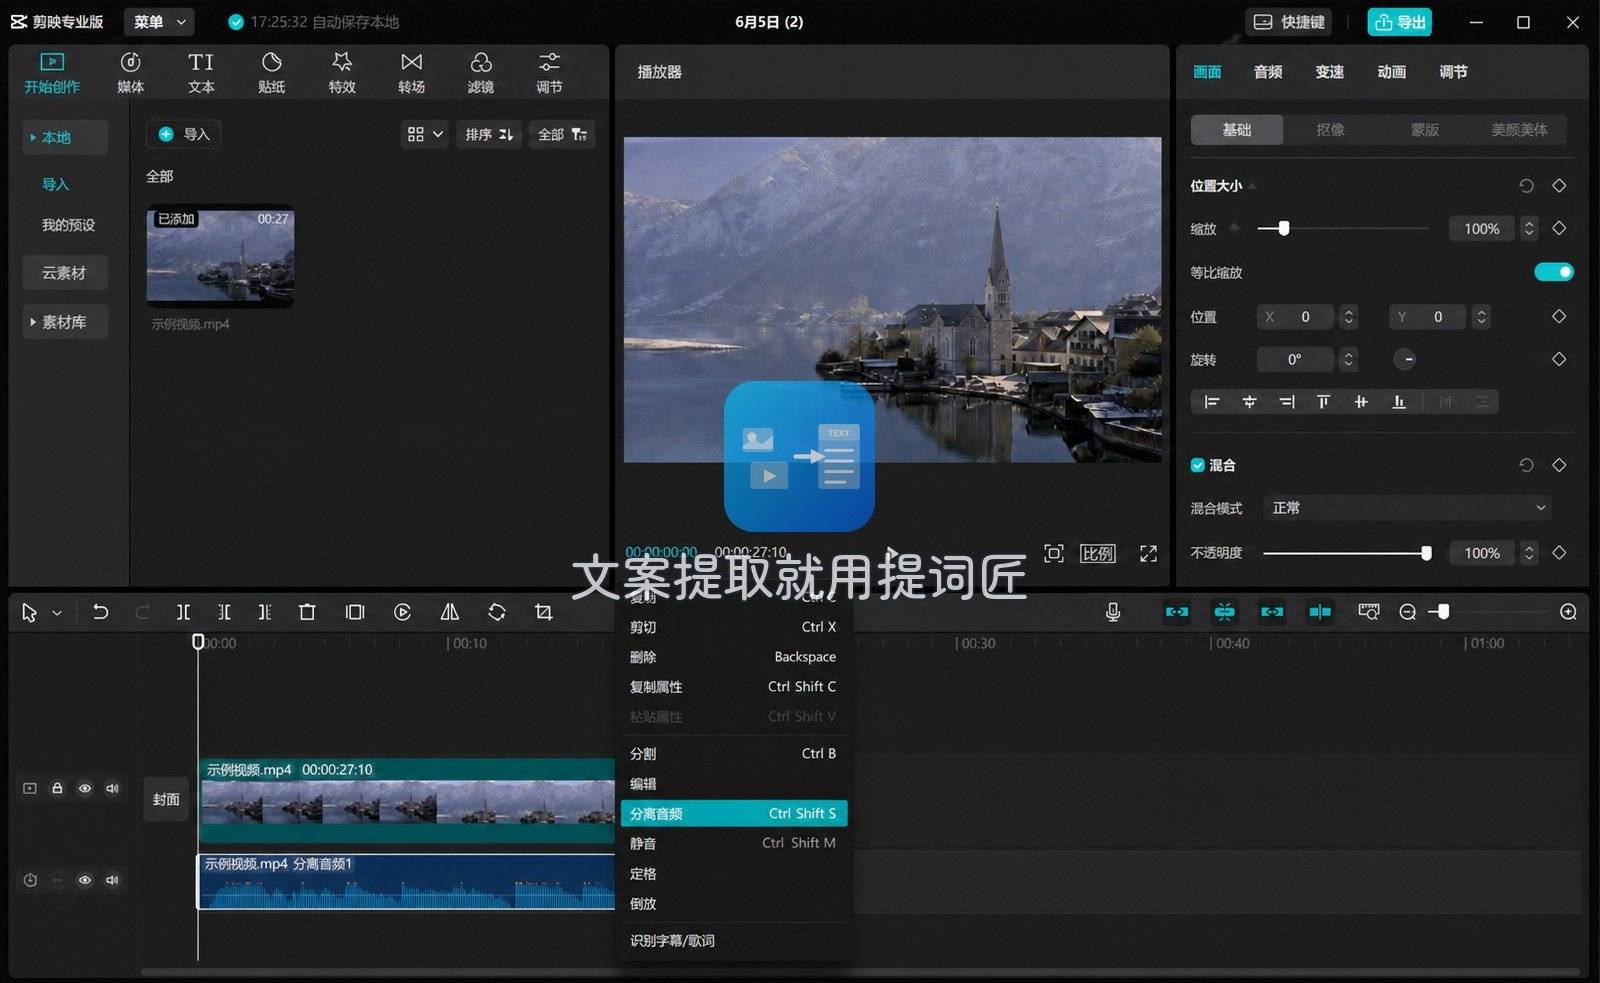
剪映的好处是剪辑和导出在一起,掐头去尾很准。剪映有些功能要开会员才能用,哪些收费以官方说明为准。
第二类:电脑上真正分离人声和背景音乐
真正把人声和伴奏拆开,靠的是训练过的音源分离模型。常见的有下面几种:
Audacity 加 OpenVINO 插件:有界面、本地跑
Audacity 是免费开源的音频编辑器,装上英特尔做的 OpenVINO 人工智能插件后,菜单里会多出「Effect › OpenVINO AI Effects › Music Separation」。选 2-Stem 拆成人声和伴奏两条,选 4-Stem 拆成鼓、贝斯、其他乐器和人声四条。整个过程在自己电脑上完成,不用上传。
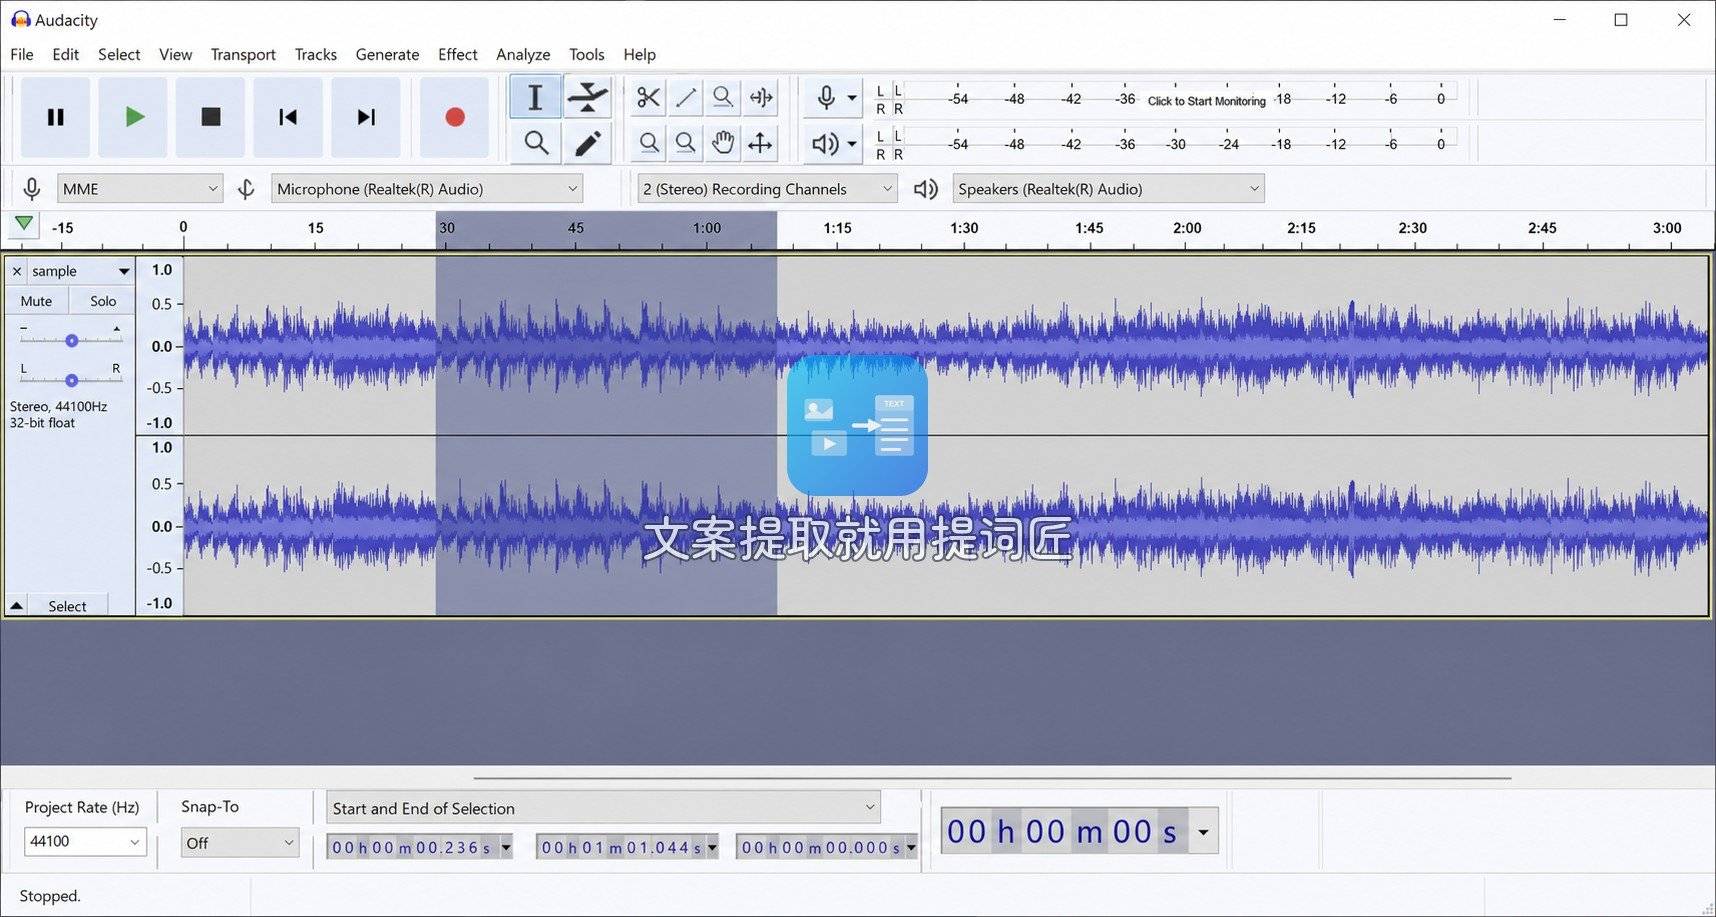
有个小坑:Audacity 官网下载页写着这套插件暂时还不兼容当前新版 Audacity,要装插件页面给的对应版本,别直接装新版再找菜单。
Spleeter、Demucs:命令行开源模型
Spleeter 是音乐平台 Deezer 开源的分离库,自带 2 轨、4 轨、5 轨三种预训练模型,速度快。Demucs 是 Meta 开源的模型,新一些的版本在分离质量上普遍被认为更好,代价是吃电脑性能,没有独立显卡会慢不少。这两个都要装 Python、在命令行里运行,适合愿意折腾的人。第一次运行时会自动下载模型文件,网络不好的话要多等一会儿;之后再用就是本地计算,断网也能跑。Spleeter 官方已经不怎么更新了,新装的话我会直接从 Demucs 开始。
不想敲命令的,可以用 Ultimate Vocal Remover 这类开源的图形界面程序,它把多种分离模型打包好,选文件、选模型、点开始就行。
第三类:在线人声分离网站
搜「在线人声分离」能找到很多网站,上传一首歌,过一会儿下载人声和伴奏两个文件。好处是不用装软件,手机浏览器也能用;要留意的地方也不少:
- 文件要传到对方服务器,私人录音、未公开的作品要先想清楚;
- 多数网站对文件大小、时长、每天次数有限制,高质量导出常常要付费,以各网站页面为准;
- 有的网站只收音频,传视频会被拒,这时候还是得先做一次提取。
几种分离人声和背景音乐的做法对比
| 做法 | 输出 | 在哪跑 | 上手难度 | 适合 |
|---|---|---|---|---|
| 提词匠视频转MP3 | 整轨 MP3,不拆人声 | 云端,需联网 | 点几下 | 手机里的视频先变音频 |
| 剪映专业版分离音频 | 整轨音频轨,不拆人声 | 电脑本地 | 低 | 剪辑时单独处理声音 |
| Audacity + OpenVINO | 人声、伴奏,或四轨 | 电脑本地 | 中,要装插件 | 想要界面又不想上传 |
| Spleeter、Demucs | 二到五轨 | 电脑本地 | 高,要命令行 | 批量处理、追求质量 |
| 在线人声分离网站 | 人声、伴奏两条 | 对方服务器 | 低 | 偶尔用一两次 |
为什么拆出来总有残留
分离人声和背景音乐本质上是「猜」:模型根据学过的大量歌曲,判断每一小段声音更像人声还是乐器。录音棚里干净的流行歌,人声和伴奏分得比较清楚;现场录像就难多了,人声带着混响,观众的欢呼和乐器糊在一起,拆出来的人声常有「水声」,伴奏里还能隐约听到歌词。和声、合唱、电音效果重的歌也一样难分。
所以素材越干净,结果越好。同一首歌,用平台上的原版音频去分,比用手机对着音箱录的视频去分效果好得多。
动手分离之前,我一般先做两件事。一是先截取要用的那一段,整首几分钟的歌拿去跑模型,电脑要算好一阵,只截副歌那三十秒,几十秒就出结果,试几种模型也不心疼。二是给分离工具喂尽量没被反复压缩的音频,原视频能直接抽就别用转发过几次的版本,码率低的 MP3 先天就少了细节,模型分得再好也补不回来。
按需求选:我的几点建议
- 只想把视频里的声音存下来:不需要人声分离,整轨提取就够了。手机上用提词匠,电脑上用剪映或者播放器自带的导出。
- 想要伴奏练歌、偶尔一两首:先把视频转成音频,再丢进在线人声分离网站试试,不满意再换本地工具。
- 做视频、经常要换背景音乐:在电脑上装 Audacity 加插件,或者 Ultimate Vocal Remover,本地处理不用每次上传。
- 成批处理或者对质量要求高:花一个下午配好 Demucs,之后一条命令处理一整个文件夹。
还有一条:分离出来的人声和伴奏,如果来自别人的歌曲,自己练习可以,公开发布前要确认授权。
回到开头那个问题,分离人声和背景音乐之前先问自己要的是整轨还是拆开的两条。我的习惯是手机里的视频先用提词匠转成 MP3,需要拆的时候再放到电脑上的 Audacity 里分,两步各用顺手的工具,比找一个「全能」软件省心。