扫描件转文字错字多,多数时候不怪识别工具,是扫描件本身给的信息不够:分辨率低、页面歪、有阴影、字太小、双栏排版,占上任何一条,结果都会乱。先对照下面几种现象找到原因,再决定是重扫一遍、修一下图,还是换个识别办法。我平时用提词匠的图片转文字处理单页扫描件,文中也会讲清楚它能做和做不了的部分。
(官方说明)提词匠有 iPhone、安卓 App 和微信小程序三个入口,同一个微信账号登录,积分和会员三端互通。
扫描件转文字出错,先看是哪种现象
同样是「错字多」,表现不一样,原因也不一样。拿到识别结果先别急着逐字改,花一分钟对一下属于哪一类:
- 整段乱码或者缺字:多半是图太糊、太小,或者整页偏暗;
- 同一个字反复认错,比如「己」「已」不分、数字 0 和字母 O 混着出:字号太小,笔画糊在了一起;
- 句子前后串行,左边半句接着右边半句:页面是双栏,或者带表格;
- 只有页边或某个角出错:纸面有弧度、有阴影,装订线那一侧被压暗;
- 夹着莫名其妙的字:印章、水印、背面透过来的字被当成了正文。
下面按原因一个个讲怎么判断、怎么处理。
原因一:分辨率不够,字太小
判断方法很简单:把扫描件放大到正文那一级,如果笔画边缘已经发虚、起锯齿,识别也只能靠猜。手机拍的文件离得太远、纸只占画面一小块,也是同一个问题。
- 用扫描仪的,分辨率调到 300 dpi 左右再扫;正文是小五号或者更小的字,可以再往上调一档。
- 用手机拍的,让纸张占满画面。先试试不开闪光灯,闪光灯容易在纸中间打出一块反光。
- 一页内容特别密的,分成上下两半各拍一张,比整页拍一张认得准。
导出时也别把图压得太狠。有些扫描 App 默认选「省空间」画质,几百 KB 的整页图乍看能读,放大全是色块。提词匠图片转文字的单张上限是 10 MB,一页 A4 的清晰扫描件一般到不了这个数,没必要为了省空间降画质。
原因二:页面歪斜、带弧度或者有阴影
扫书的时候很常见:靠近书脊的那几行字往下弯,颜色也更暗,这几行的错字会比别处多得多。拍照时手机没端平,整页拍成梯形,也是类似的情况。
- 拍书时把书压平,或者一次只拍一页,书脊那一侧多留点边;
- 用扫描类 App 的裁边、透视校正,把梯形拉回长方形再识别;
- 阴影重的,先在相册里把亮度和对比度往上调一点,让底色接近白、字接近纯黑。
这一步做完,扫描件转文字的结果通常会好一大截,比来回换工具管用得多。
原因三:双栏、表格和复杂排版
报纸、论文、合同附件经常是双栏。识别工具按行从左往右读,就会把左栏第一行和右栏第一行拼成一句。表格也一样,几个格子里的字被读成一长串。
遇到这种页面,我的做法是先裁图再识别:用相册的裁剪功能把左栏、右栏分别存成两张图,一张一张识别,再按顺序拼起来。表格内容少的,一列一列裁;表格大的,交给专门做表格识别的办公软件处理,别指望普通的扫描件转文字把格子原样还原。
这里要说清楚:提词匠的图片转文字识别只输出文字,不还原表格和版式,加粗、分栏、表格线都不会保留。要的是能复制的正文,它够用;要一份和原件排版一样的 Word,它做不到。
原因四:手写、特殊字体和印章水印
手写体、艺术字、竖排繁体,对哪个识别工具都是难项。印章压在字上、文件带满屏水印、纸太薄透出背面的字,也会混进奇怪的字符。
- 手写的部分,字数少就直接手打,字数多至少保证拍清楚、光线均匀;
- 被印章和水印挡住的几个字,识别后对着原件补上,别让它拖累整页;
- 背面透字的,在纸背后垫一张深色的纸再拍,透字会淡很多。
用提词匠做单页扫描件转文字的步骤
图修好之后再交给工具。提词匠有 iPhone App、安卓 App 和微信小程序三个入口,用同一个微信账号登录,积分三端通用,下面这几步在三个入口里是一样的。
第 1 步:在常用工具里找到图片转文字
打开提词匠,首页上半部分是短视频转文字,下面是「常用工具」列表,往下翻就能看到图片转文字,点进去。
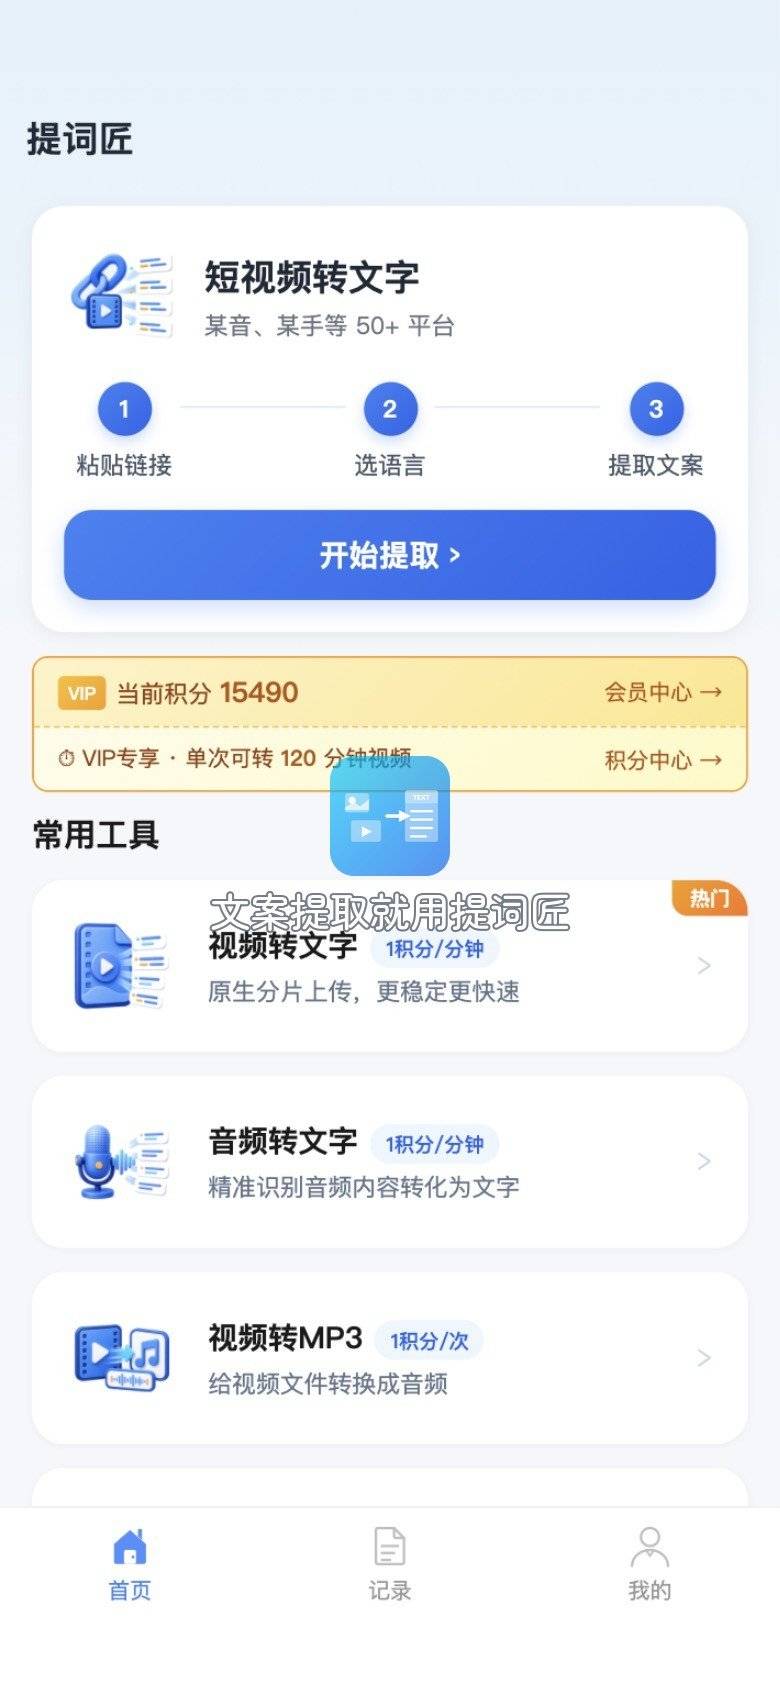
第 2 步:选一张扫描件,等它识别
从相册选一张图,一次只能选 1 张,单张不超过 10 MB。选好后弹出「正在识别」,一般几秒钟出结果。多页的扫描件只能一页一页传,几十页的整本资料用这个办法会比较费时间,这是它的短板。
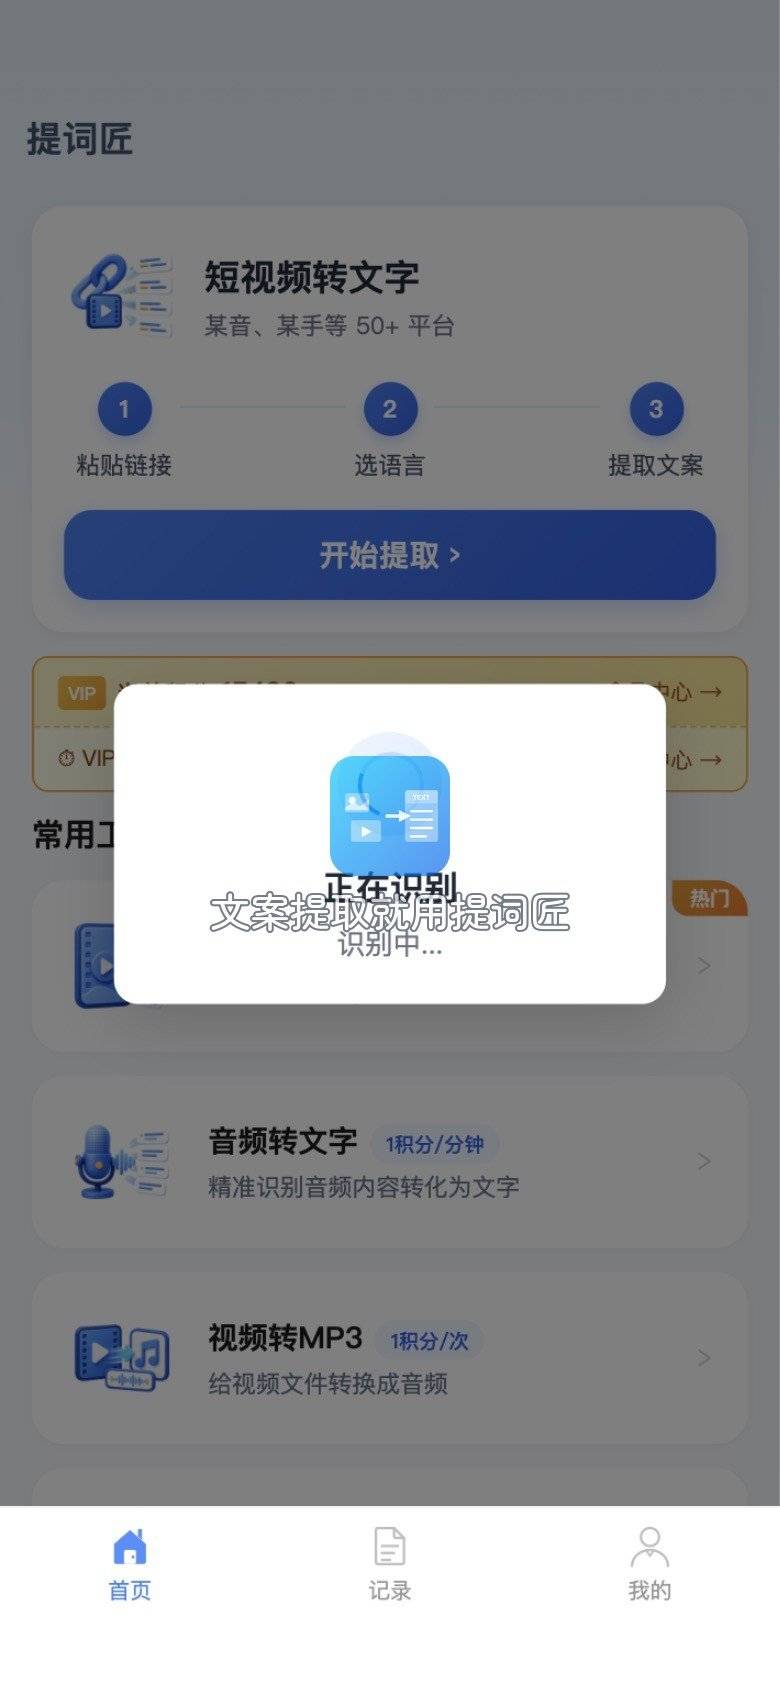
第 3 步:在结果页复制出来再校对
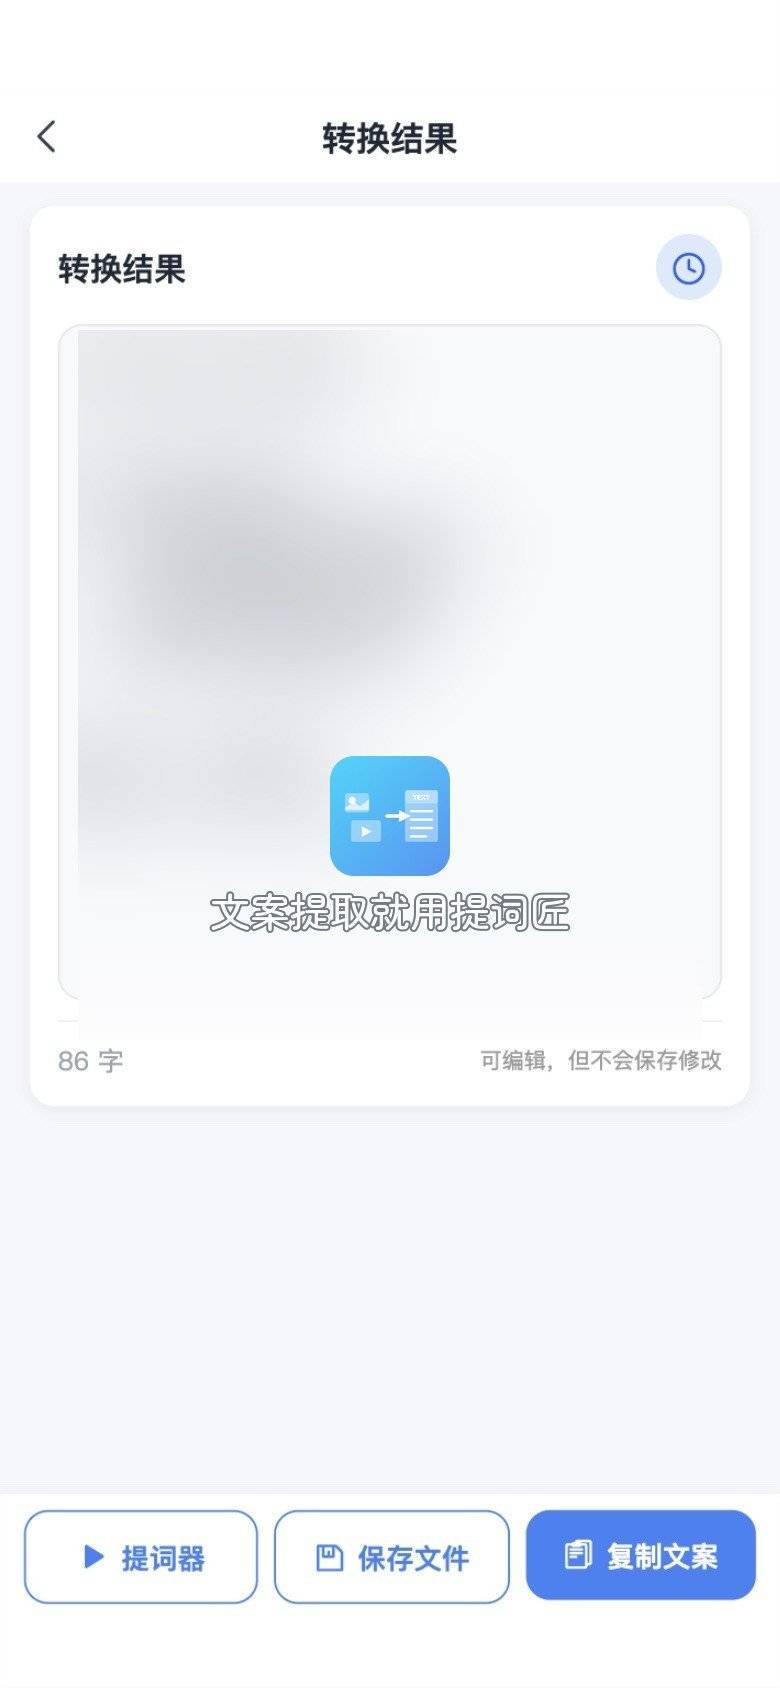
识别完成后进入转换结果页,底部有「复制文案」按钮,复制后粘到备忘录或 Word 里校对。结果框里能直接改字,但页面写着「可编辑,但不会保存修改」,所以改之前先复制走。图片转文字每次扣 2 积分,需要联网。
扫描件已经在电脑里,怎么提取文字
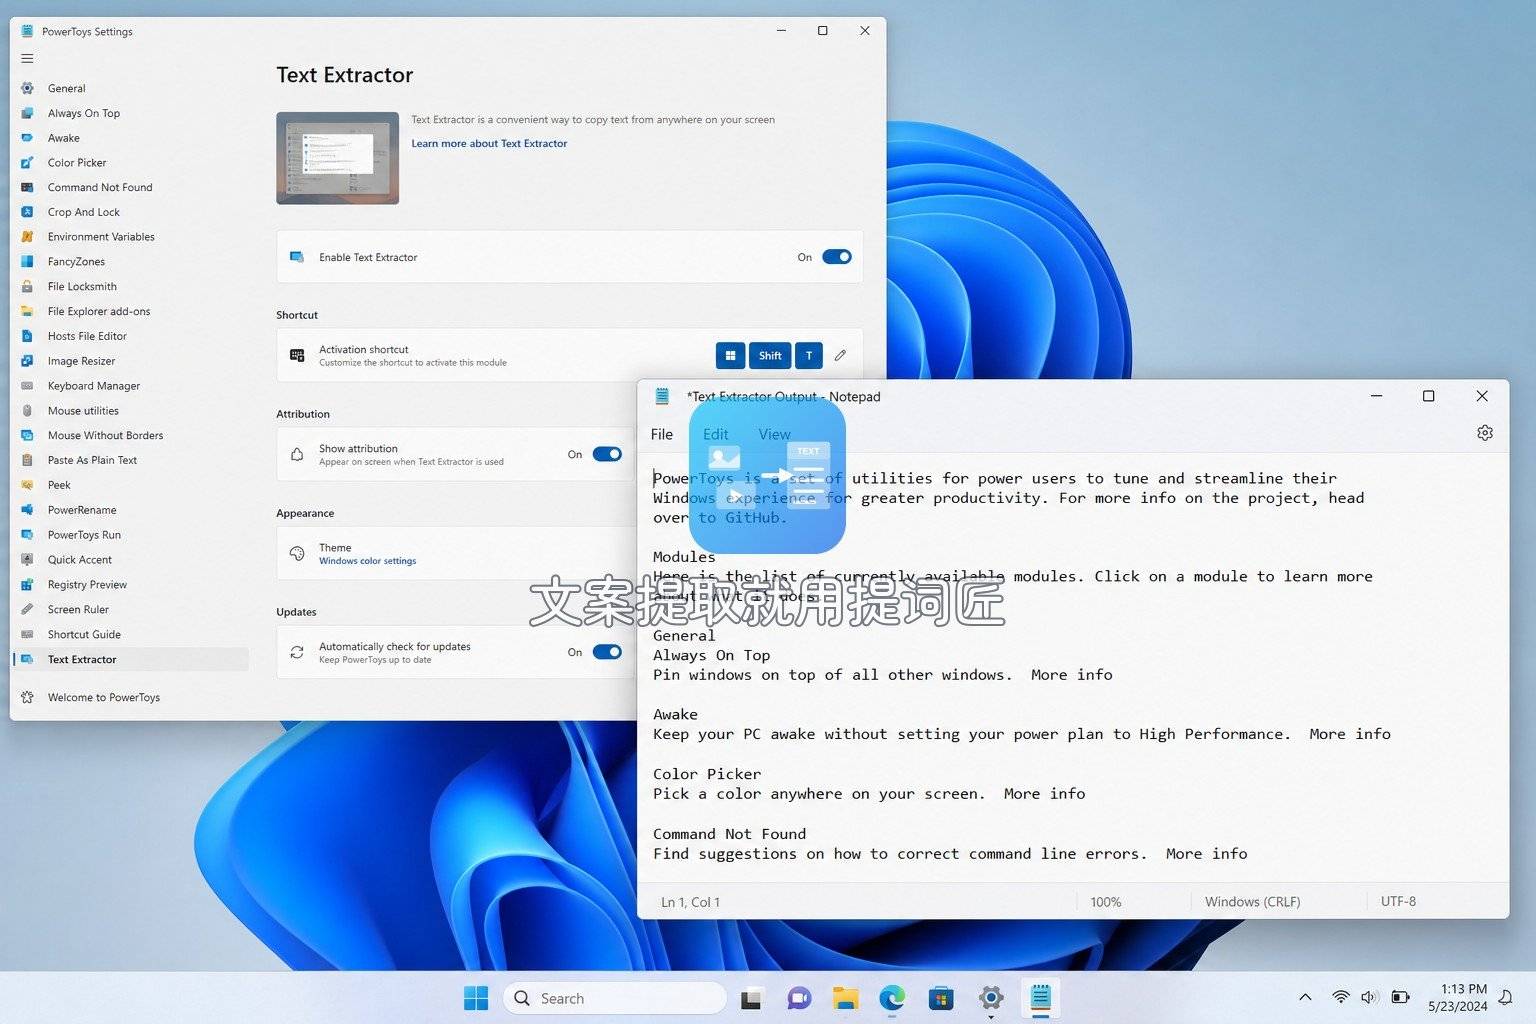
扫描件存在电脑上的,有两个办法。一是在微信电脑版里打开提词匠小程序,用法和手机上一样,充值才需要回到手机上操作。二是用微软给 Windows 出的免费工具 PowerToys,里面的文字提取器默认按 Win+Shift+T 唤出,框选屏幕上任意一块区域,文字就进了剪贴板。扫描件图片提取文字只要一两段的时候,它很顺手。它能认哪些语言取决于系统装了哪些语言包,识别中文前先确认电脑装了中文的识别组件。
识别完之后,校对按这个顺序来
- 先通读一遍,读不通的句子标出来,回头只核这些;
- 数字、日期、金额、人名逐个对原件,这一类错了后果大;
- 同一个错字反复出现的,用查找替换一次改完;
- 多余的换行统一处理:识别结果常常按原件每一行断开,粘进 Word 后用替换把段落中间的换行去掉。
几个容易遇到的情况
扫描件是 PDF,能直接传吗?
图片转文字识别只收图片。PDF 扫描件先截图或导出成图片,再一页一页处理。
识别结果能保留原来的格式吗?
只保留文字和大致的换行,字体、表格、分栏都不保留。
同一张纸换个角度拍,结果为什么差这么多?
角度一变,透视和光线都跟着变。扫描件转文字对画面端不端正很敏感,尽量正对纸面拍,四个角都留在画面里。
扫描件图片提取文字,App 和小程序结果一样吗?
一样,三个入口用的是同一套识别能力,积分也通用。要下载 App,认准提词匠的唯一官网 www.ticijiang.com 上给出的入口。
先修图,再识别
扫描件转文字错字多,就按这个顺序排查:图够不够清楚,页面正不正,排版复不复杂,有没有手写和印章。前两条解决了,大部分错字会消失;后两条靠裁图和人工补字。我的习惯是先在相册里裁好、调亮,再交给提词匠识别,复制出来对一遍原件,一页几分钟就能处理完扫描件转文字这件事。